O relatório diz que a página falhou, mas ela abre no seu computador. Os logs guardam o que o servidor respondeu em outros acessos, inclusive os do Google. Numa análise de logs para SEO, você usa esse histórico para descobrir quando o erro aconteceu e quais endereços ele atingiu.
O que dá para responder com os logs
Os registros de acesso mostram solicitações recebidas por um servidor ou por uma camada de entrega, como uma CDN. Eles podem informar a URL pedida, o horário, o código da resposta, o agente de usuário e outros campos definidos na configuração.
Você consegue procurar a visita a uma página publicada, localizar respostas com erro e comparar quais grupos de URLs recebem mais pedidos. É uma visão diferente da oferecida por um crawler: o crawler testa o acesso quando você executa a coleta; os logs mostram pedidos que ocorreram durante o período registrado.
O Search Console acrescenta a leitura do Google sobre rastreamento e indexação. Já os logs não dizem que uma página entrou no índice ou recebeu um clique na busca. Um pedido com resposta 200 informa que o servidor atendeu aquela solicitação. O que o Google fez com o conteúdo vem depois.
Também é possível ver acessos a imagens e arquivos de código. Por isso, contar todas as linhas e chamar esse total de “páginas rastreadas” distorce a leitura. Separe os tipos de recurso e os endereços antes de comparar volumes.
O que pedir à hospedagem antes de começar
Peça os registros de acesso do domínio, com o intervalo em que a dúvida ocorreu. Os registros de erro da aplicação podem ser necessários para explicar uma falha, mas não substituem a lista de solicitações recebidas.
Explique quais páginas você pretende investigar e confirme se a hospedagem ainda guarda aquele período. Arquivos podem ter sido rotacionados, resumidos ou apagados conforme a retenção. Um relatório com dados por amostragem também precisa ser tratado como amostra.
Há um detalhe que muda a interpretação: qual camada registrou o pedido? Se a CDN entregou uma página em cache, o servidor de origem pode não ter recebido a solicitação. A ausência no log da origem, nesse caso, não responde se o Google acessou a página pela CDN.
Antes de juntar arquivos de lugares diferentes, confirme o fuso dos horários e a unidade de duração. A mesma hora escrita em UTC e em Brasília representa momentos distintos. E um valor de duração em microssegundos não pode ser comparado diretamente com outro em milissegundos.
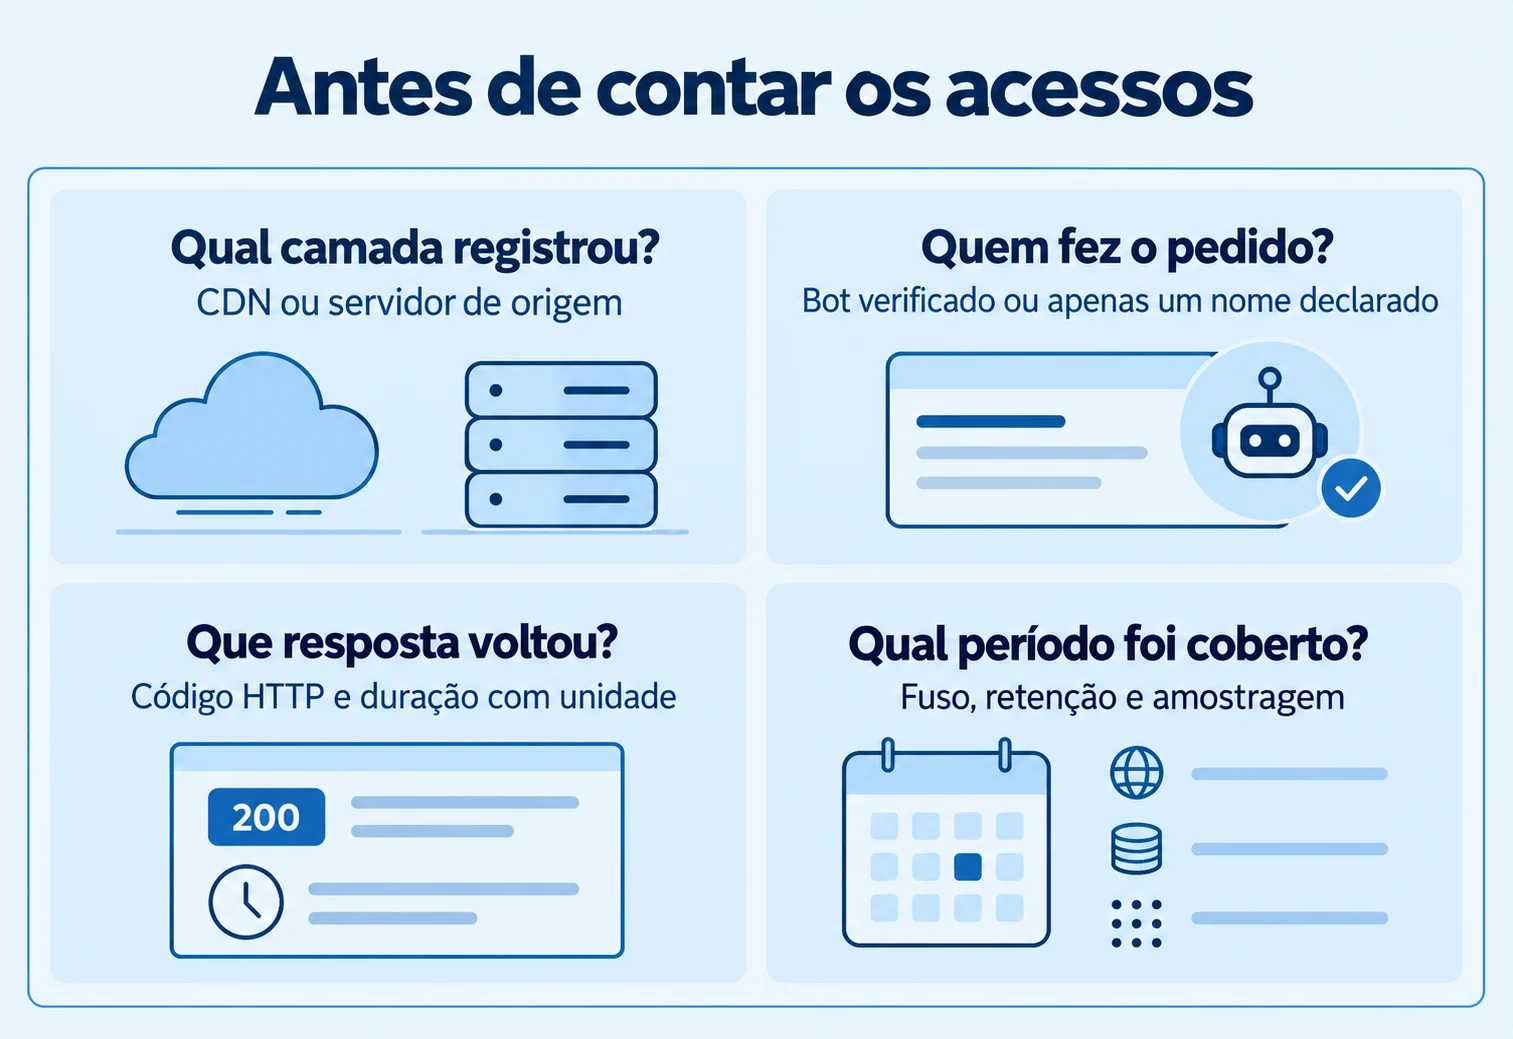
Para uma primeira leitura, estes campos costumam ser suficientes:
| Campo | O que procurar |
|---|---|
| Horário e fuso | O momento do pedido e sua relação com a publicação ou com o incidente |
| Host, caminho e parâmetros | A versão exata da URL solicitada |
| Método e código HTTP | O tipo de pedido e a resposta entregue |
| IP de origem e user-agent | Os dados necessários para verificar quem fez o pedido |
| Duração e bytes, quando registrados | Tempo e tamanho da resposta, com as unidades do formato utilizado |
O formato dos registros no Apache, por exemplo, depende da configuração do servidor. Outras plataformas usam campos e nomes diferentes. Peça a descrição do arquivo junto da exportação, em vez de adivinhar o significado de cada coluna.
Se for compartilhar os dados para uma revisão, limite o material ao período e às URLs necessários. Retire cookies, tokens, dados de formulários e informações pessoais que não participam do diagnóstico. O relatório público pode mostrar o comportamento encontrado sem expor os registros brutos.
Como ler uma linha de acesso
O exemplo abaixo é didático. O IP pertence a uma faixa reservada para documentação e não representa um visitante nem um acesso verificado do Google:
203.0.113.10 - - [10/Mar/2026:12:30:00 +0000]
"GET /categoria/?page=2 HTTP/1.1" 200 18432
"-" "Googlebot"
O pedido foi feito por GET ao caminho /categoria/?page=2. O servidor informou status 200 e, neste formato de exemplo, 18.432 bytes de corpo da resposta. O texto “Googlebot” é o agente declarado. A origem ainda precisa ser verificada antes de entrar numa contagem atribuída ao Google.
O fuso +0000 indica UTC. Uma publicação feita às 9h30 em Brasília, no fuso UTC−3, corresponde a 12h30 UTC. Se você procurar o incidente às 9h30 num arquivo que usa UTC, estará lendo outro momento. Converta os horários antes de cruzar a publicação, o erro da aplicação e o acesso do robô.
A duração nem aparece nessa linha. Para investigar lentidão, peça que a hospedagem exporte esse campo, se ele já estiver registrado, e informe a unidade. Não deduza o tempo de resposta a partir dos bytes ou do horário do pedido.
Um pedido para enviar à hospedagem
Preciso dos logs de acesso do domínio no intervalo do incidente, incluindo host, caminho completo com parâmetros, método, status HTTP, horário com fuso, IP e user-agent. Se houver, incluam duração com a unidade, status de cache e identificador da requisição. Informem se o arquivo vem da CDN ou da origem, se é completo ou amostrado e qual período ainda está disponível.
Acrescente a esse pedido duas ou três URLs afetadas. Se já houver um protocolo de atendimento, use o mesmo: ele facilita reunir o histórico e evita que cada resposta examine um intervalo diferente. Receba os arquivos num canal privado autorizado e monte o relatório com contagens e exemplos sem dados pessoais.
Como confirmar se o acesso veio do Google
O nome “Googlebot” no user-agent é uma declaração de quem fez a solicitação. Outro programa pode usar esse mesmo texto. Para atribuir os acessos ao Google, a equipe precisa verificar a origem.
Há duas formas previstas pelo Google: conferir o IP nas listas oficiais de intervalos ou verificar o DNS reverso e o direto. Na verificação por DNS, o caminho é:
- Consultar qual nome de host corresponde ao IP que aparece no registro.
- Conferir se esse nome pertence ao domínio usado pela categoria de rastreador que você está verificando.
- Consultar os IPs desse nome de host e confirmar a correspondência com o IP original.
Encontrar a palavra “Google” em algum trecho do nome não encerra a verificação. A correspondência precisa seguir os domínios e as faixas publicados para aquela classe de acesso.
Os métodos oficiais de verificação separam rastreadores comuns, como o Googlebot, de coletores acionados pelo usuário. Essa separação importa: um teste que alguém iniciou numa ferramenta do Google não é a mesma coisa que uma visita automática para a Pesquisa.
Como aplicar a verificação sem aceitar um bot falso
Para um IP real do arquivo, a equipe consulta primeiro o DNS reverso e depois o DNS direto do nome recebido. Em sistemas com o comando host, o fluxo é host IP_DO_LOG e, na sequência, host NOME_RETORNADO. No Windows, o nslookup também permite essas consultas. Os nomes em maiúsculas representam os valores que precisam ser substituídos, não comandos prontos para colar.
O nome deve terminar no domínio oficial da categoria de rastreador. Um endereço como googlebot.com.exemplo.net pertence a exemplo.net. Ele não vira Googlebot por conter o nome no início. Após validar o domínio, a consulta direta deve incluir o IP original. Guarde o resultado da verificação junto da classificação daquele acesso.
Para muitos registros, use as listas oficiais em formato CIDR e uma comparação de endereços, não uma busca de texto pelo prefixo do IP. Mantenha listas separadas para rastreadores comuns e coletores acionados por usuários. Um acesso do teste de URL que você acabou de executar deve continuar identificado como teste, sem entrar como evidência de que o Googlebot passou espontaneamente pela página.
O IP registrado pertence ao visitante ou à CDN?
Se o log da origem mostra o mesmo IP de proxy em quase todos os pedidos, ele pode estar registrando quem entregou a conexão ao servidor. Esse endereço não serve para verificar se o visitante era o Googlebot.
Peça os registros da borda ou o campo de IP original configurado pela hospedagem. A infraestrutura precisa confiar apenas nos intermediários autorizados para preencher esse dado. Não aceite qualquer cabeçalho enviado pelo visitante como prova da origem. Depois, aplique a verificação às solicitações que realmente pertencem à categoria de rastreador analisada.
Como transformar os acessos numa resposta para o site
Depois de conferir a origem e a cobertura dos dados, escolha a pergunta que precisa responder. Eu trabalharia com um grupo definido de URLs e um período comparável. Isso evita passar horas num painel de contagens sem chegar à decisão que motivou a coleta.
As páginas novas receberam uma visita?
Separe os endereços publicados no período e procure o primeiro acesso do Googlebot verificado depois da publicação. Veja também o código que voltou. Uma visita que recebeu 503 não equivale a uma leitura bem-sucedida do conteúdo.
Quando não houver registro, confira antes a retenção, a camada de entrega e os filtros da exportação. Depois compare os caminhos de descoberta, como links internos e sitemap. A conclusão deve respeitar o que aquele arquivo consegue mostrar.
Quais endereços estão concentrando os pedidos?
Agrupe os acessos por padrões que tenham função no site: produtos, categorias, filtros, imagens e endereços antigos. Compare quantas URLs diferentes aparecem e com que frequência são revisitadas.
Se há muitas solicitações a combinações de filtros que a loja não quer na busca, você tem um grupo concreto para revisar. Isso é mais útil do que escolher uma porcentagem arbitrária de acessos “desperdiçados”. A discussão de crawl budget precisa considerar o tamanho do inventário e as páginas que estão esperando.
Onde o servidor começou a falhar?
Filtre os códigos com erro e compare o início das falhas com o horário das mudanças no site. Veja se os mesmos caminhos falharam para o Google e para outros visitantes. Quando houver um intermediário, como uma CDN, compare os registros dele com os da origem.
Leve os exemplos e os horários a quem mantém a aplicação. Se uma publicação alterou o modelo de produtos e os erros começaram naquele grupo, a equipe tem um trecho do código para examinar. Os registros de erro podem então explicar o que o log de acesso apenas apontou.
Depois da correção, repita a leitura para as mesmas URLs e confirme as novas respostas. Esse retorno faz a análise de logs participar do trabalho de SEO técnico, em vez de virar uma exportação que ninguém consulta de novo.
Como montar uma leitura que leve a uma correção
Faça primeiro uma tabela por dia e por grupo de páginas. Conte pedidos, URLs únicas de HTML, respostas com erro e revisitas. Depois abra os endereços que explicam as diferenças. Manter a URL completa até essa etapa evita juntar um produto válido a uma combinação de filtro sem resultado.

Num cálculo didático, 1.000 pedidos para 100 URLs de HTML equivalem a dez pedidos por URL em média. Essa média pode esconder 901 pedidos para uma única URL e um pedido para cada uma das outras 99. Ordene também pela frequência individual. O objetivo é descobrir se o volume vem de uma distribuição ampla ou de poucos caminhos repetidos.
Para investigar erro, calcule a proporção de respostas 5xx dentro do mesmo grupo e intervalo, junto do número absoluto. Dez falhas em vinte pedidos representam uma condição diferente de dez em cem mil. Ainda assim, se os dez pedidos afetaram a única página que recebe orçamentos, a prioridade comercial pode ser alta. Leve a URL e a tarefa interrompida para a decisão.
Finalize o relatório com o que será alterado e como a equipe verificará o efeito: atualizar links que apontam a uma cadeia antiga, corrigir o modelo que devolve 503 ou parar de publicar combinações redundantes. Na leitura seguinte, volte aos mesmos padrões e horários comparáveis. Um total menor de acessos pode ser desejável se o Google deixou de percorrer duplicações e continuou chegando às páginas necessárias.
Conclusão
Peça os logs com uma questão definida: quais páginas, qual período e qual comportamento você precisa explicar. Antes de contar visitas, confirme de onde vieram os registros e quais acessos realmente pertencem ao Google.
Se a equipe tem os arquivos, mas precisa ligar esse histórico às correções do site, podemos trabalhar isso no acompanhamento de SEO técnico. A análise orienta o que mudar e volta depois da publicação para conferir como os acessos passaram a responder.