As páginas novas estão publicadas, aparecem no sitemap e continuam sem uma visita do Google. Se isso acontece com uma parte grande do seu catálogo, o crawl budget entra na investigação. Ele é a quantidade de URLs que o Google consegue e pretende rastrear no seu site, considerando a resposta do servidor e o conteúdo que tem para buscar.
A pergunta que eu faria primeiro é: quais páginas estão esperando e há quanto tempo? Um gráfico com menos acessos não responde isso. Você precisa chegar aos endereços afetados, separar quem já recebeu uma visita de quem ainda aguarda e descobrir o que está tomando o tempo do rastreador. Vamos fazer essa leitura antes de escolher o que mudar.
Quando o crawl budget merece atenção
Eu investigaria o crawl budget em catálogos grandes, sites com muitas atualizações e ambientes que produzem combinações de URLs sem controle. Se uma loja abre centenas de milhares de endereços de filtros enquanto produtos recém-publicados passam dias sem uma visita, a distribuição desses acessos merece atenção.
Em um site pequeno, com páginas lidas pouco depois da publicação, eu colocaria outras tarefas na frente. O próprio tamanho do site precisa entrar na conversa junto com a frequência de mudança e a espera observada. A orientação avançada do Google usa exemplos de milhões de páginas ou de mais de dez mil páginas que mudam diariamente, como referências aproximadas. Não são limites a partir dos quais o problema começa automaticamente.
Para decidir se vale aprofundar, procure um grupo de páginas que deveria estar recebendo visitas e compare a data de publicação com o último rastreamento. Se a espera se repete em uma parte relevante do catálogo, leve esse grupo para a investigação. Se ocorre em um endereço isolado, comece por ele.
O que determina as visitas do Google
Há duas partes nessa conta: quanto o site consegue atender e quanto o Google pretende buscar. Elas explicam por que contratar um servidor maior nem sempre muda a frequência das visitas.
Capacidade do servidor
O Google ajusta o ritmo para não sobrecarregar o host. Respostas estáveis e rápidas permitem mais conexões. Lentidão, erros 5xx e respostas 429, usadas para limitar solicitações, levam o rastreador a reduzir o ritmo.
Esse limite considera o nome do host. www.exemplo.com e loja.exemplo.com são hosts distintos nesse contexto. A capacidade é compartilhada pelos rastreadores do Google que acessam o mesmo host, enquanto cada um tem sua demanda. Por isso, os acessos que aparecem no servidor não se resumem ao Googlebot da Pesquisa.
Se o site começou a responder com erros durante um pico de visitas, a equipe de infraestrutura precisa examinar esse período. Pode haver uma aplicação lenta, uma regra de proteção bloqueando o bot ou falta de recursos no servidor. Trocar a hospedagem sem localizar o gargalo é um gasto que eu evitaria.
Demanda de rastreamento
Mesmo com o servidor saudável, o Google escolhe o que visitar e revisitar. Entram nessa decisão os endereços que ele conhece, as mudanças no conteúdo, a popularidade e o valor das páginas para a Pesquisa.
Um site que expõe muitas versões equivalentes aumenta o inventário de URLs que o buscador precisa examinar. É o que acontece quando ordenação, filtros e parâmetros geram caminhos diferentes para conteúdos quase iguais. A equipe precisa decidir quais desses caminhos têm função na busca e quais existem apenas para a navegação.
Também vale olhar para as páginas que ninguém alcança pelos links do site. O sitemap apresenta endereços ao Google, mas a navegação mostra como eles se encaixam no restante do conteúdo. Uma página importante perdida fora da estrutura exige outro tipo de correção.
Como investigar as páginas que estão esperando
Abra uma das URLs afetadas na inspeção do Search Console. Leia o motivo de exclusão e a data do último rastreamento. O teste ao vivo serve para examinar o acesso atual; os dados indexados mostram o que o Google havia processado antes.
Se a página aparece como rastreada e não indexada, o buscador já passou por ela. Examine o conteúdo entregue, as versões duplicadas e a URL escolhida como canônica. Se está descoberta e ainda não foi rastreada, continue com os caminhos de acesso e o histórico do servidor.
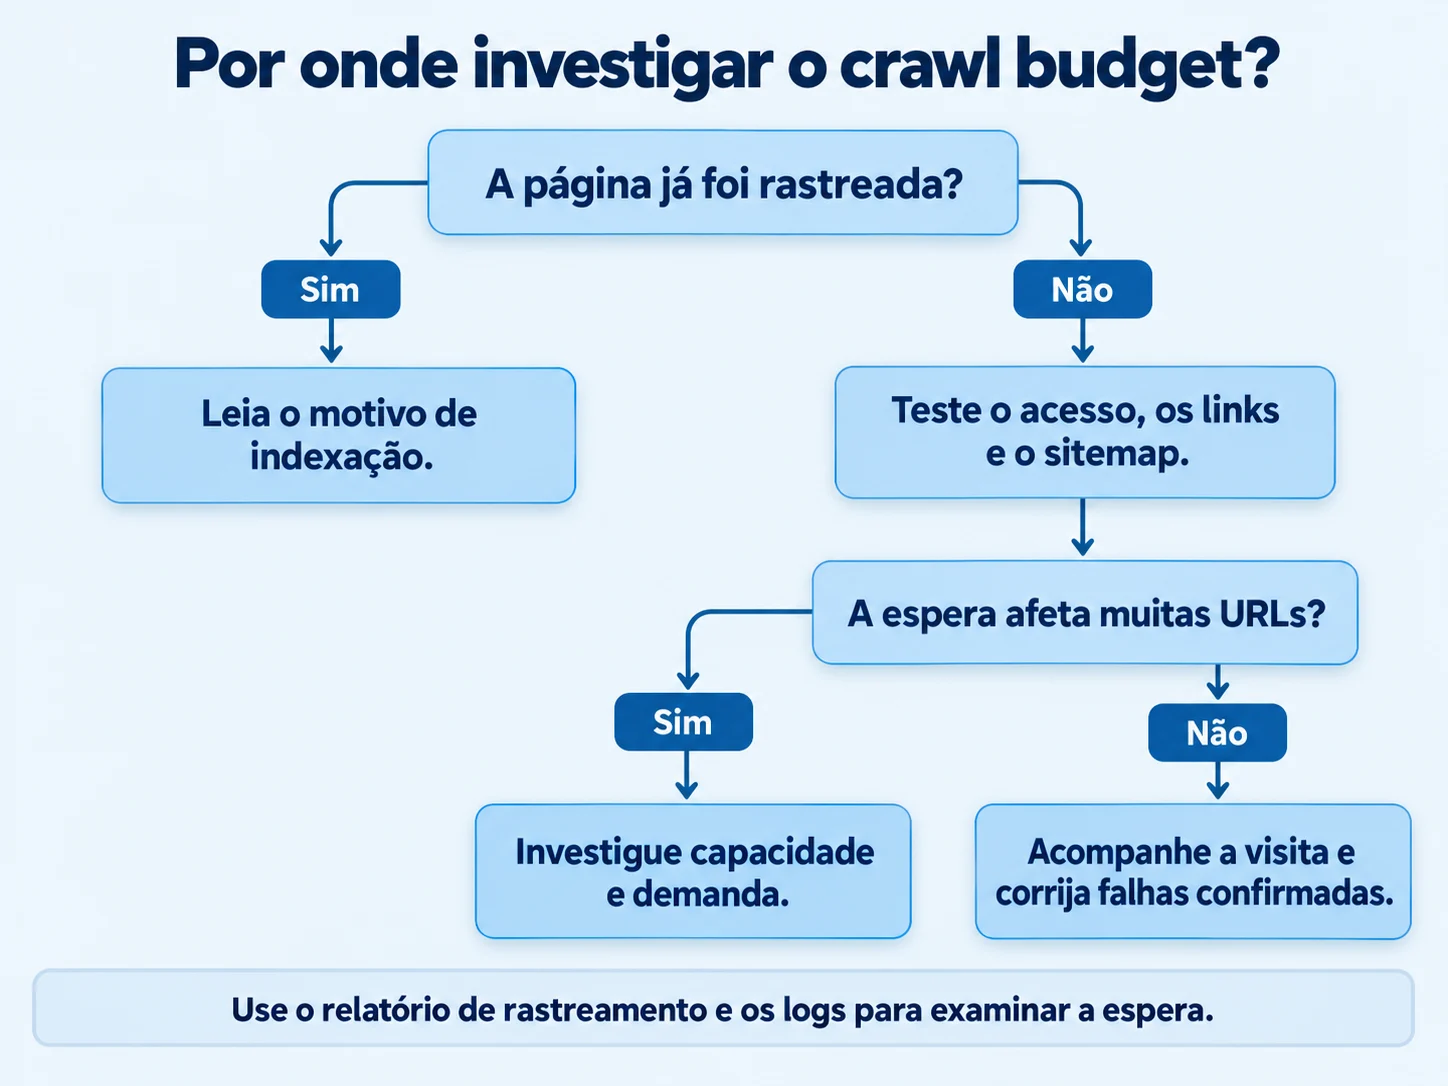
Depois, abra Configurações > Estatísticas de rastreamento. Compare os dias de espera com o tempo de resposta, os problemas de disponibilidade do host e os códigos HTTP recebidos. Uma queda de solicitações acompanhada de erros tem uma explicação diferente de um gráfico estável, sem falhas de acesso.
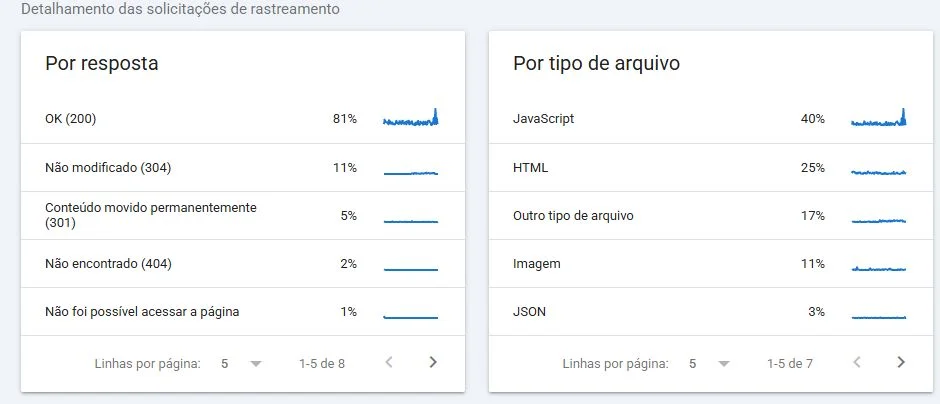
No recorte acima, HTML representa 25% das solicitações e JavaScript, 40%. Isso muda a leitura do total: boa parte dos pedidos busca recursos, não novas páginas de conteúdo. Os 11% de respostas 304 indicam reaproveitamento de conteúdo que não mudou; não são erros a corrigir. Abra os grupos de resposta para chegar aos dias e exemplos que precisam de investigação.
Olhe também o tipo de arquivo solicitado. O relatório conta pedidos ao servidor, incluindo recursos como imagens e arquivos de código. Os passos de uma cadeia de redirecionamento entram na contagem. Portanto, dez mil solicitações não significam dez mil páginas diferentes visitadas, muito menos dez mil páginas indexadas.
Para saber se o Googlebot chegou àquelas URLs específicas, a equipe pode consultar os logs do servidor ou da CDN. Peça os acessos ao grupo que está esperando, no período da publicação. Antes de atribuí-los ao Google, é preciso verificar o bot, pois qualquer programa pode se apresentar com o mesmo nome no agente de usuário.
A explicação dos campos do relatório é útil para essa leitura. O Search Console não substitui o histórico completo do servidor, e os totais das duas origens podem ter coberturas diferentes.
Como montar uma amostra que responda à sua dúvida
Comece por um grupo publicado na mesma ocasião: os produtos de uma categoria nova, por exemplo. Exporte os endereços finais pelo painel da loja e acrescente a data em que cada página ficou pública. Deixe fora rascunhos, produtos que exigem login e URLs que apenas redirecionam. Você quer medir a chegada a páginas que deveriam estar disponíveis para a Pesquisa.
Na inspeção de URL, anote a data do último rastreamento e o motivo informado. Para um conjunto pequeno, a leitura manual resolve. Em volumes maiores, a equipe pode usar a API de inspeção, respeitando as cotas, e os logs do servidor. A API informa a situação conhecida pelo Google; ela não executa o teste ao vivo de cada endereço.
Eu usaria estas colunas, sem misturar o histórico de indexação com a visita:
- URL final e data em que ficou disponível.
- Onde ela recebeu um link interno e em qual sitemap foi incluída.
- Primeiro acesso verificado do Googlebot dentro do período disponível nos logs.
- Código HTTP entregue nessa visita.
- Último rastreamento e situação de indexação mostrados na inspeção.
A data de publicação marca o início da disponibilidade. Ela não informa quando o Google descobriu o endereço. Essa diferença impede chamar de “demora do Google” um período em que a página estava escondida, bloqueada ou fora dos links e do sitemap.
Um cálculo para comparar os grupos
Vamos usar números didáticos: de 100 páginas novas, 70 receberam ao menos um acesso verificado do Googlebot no intervalo analisado. A cobertura de rastreamento dessa amostra é de 70%. Se esses acessos somaram 240 pedidos de HTML, houve revisitas; não foram 240 páginas novas descobertas. Os outros 30 endereços continuam merecendo uma leitura separada.
Calcule também o tempo entre a publicação e a primeira visita encontrada nos logs. Compare a mediana e os maiores atrasos com um grupo semelhante de um período anterior. A mediana mostra o comportamento central; as páginas mais atrasadas revelam categorias ou caminhos que a média pode esconder. Se o histórico de logs começou depois da publicação, trate a data encontrada como o primeiro acesso disponível nesse histórico.
Escolha um intervalo que combine com a operação. Um portal que atualiza notícias a cada hora tem uma necessidade diferente de um catálogo que muda por semana. O prazo útil é o tempo em que aquele conteúdo precisa chegar à busca para atender o negócio, não um número de dias copiado de outro site.
Se as 70 páginas receberam a visita e ficaram fora do índice, abra uma amostra delas. Mais requisições repetidas não explicam essa decisão. Já se os 30 endereços sem visita se concentram depois da página 10 das categorias, a navegação vira uma hipótese que você consegue testar.
Qual ajuste faz sentido para cada causa
Com o grupo de URLs e o período definidos, a conversa com quem mantém o site fica mais objetiva. Em vez de pedir “mais crawl budget”, você consegue apontar onde o acesso está parando.
| O que apareceu | O que corrigir | Como testar |
|---|---|---|
| Erros 5xx ou 429 nos acessos ao grupo afetado | Falha da aplicação, limite da infraestrutura ou regra de proteção, conforme o diagnóstico | Repetir o acesso e conferir as novas respostas nos logs |
| Muitas combinações de filtros sem função na busca | Geração e exposição desses endereços, preservando os filtros que precisam ter páginas próprias | Rastrear a navegação e comparar quais combinações continuam acessíveis |
| Páginas importantes sem links de entrada na navegação | Links em categorias, menus ou conteúdos relacionados, no contexto correto | Partir da página inicial e verificar se o rastreador chega aos endereços |
| Links internos passando por vários redirecionamentos | Destino dos links e encadeamento das regras | Confirmar que o link aponta para a URL final e que o acesso termina em 200 |
Há um cuidado com os bloqueios: uma regra no robots.txt impede a leitura, inclusive de instruções que estejam dentro da página. Ela não deve ser usada temporariamente para tentar empurrar visitas para outro lugar. Já o noindex exige que o Google acesse a resposta para ler a exclusão. É adequado para controlar a indexação, mas não resolve o desperdício de rastreamento dessa forma.
A canonical indica a versão preferida entre páginas equivalentes. O Google ainda precisa visitar versões para entender essa relação. Se o site continua produzindo combinações sem utilidade, apontar todas para uma página principal deixa a origem da multiplicação intacta.
Para páginas removidas de vez, devolva 404 ou 410. Para páginas que continuam existindo, mantenha conteúdo útil e uma resposta coerente. Evite servir uma tela de erro com status 200 ou redirecionar todo endereço inexistente para a home.
Antes de bloquear filtros, siga um caminho completo
Abra uma categoria e aplique uma combinação real de filtro e ordenação. Copie o endereço, veja quais links levam até ele e confirme se há produtos que só podem ser encontrados nesse percurso. Em seguida, teste a regra proposta para o robots.txt contra a URL do filtro, uma página de produto e uma URL de paginação.
Uma regra ampla para todo endereço com ? pode atingir ?page=2, além das combinações que você pretendia retirar do rastreamento. Bloquear esse caminho sem oferecer outra navegação deixa os produtos seguintes mais difíceis de alcançar. Defina a regra pelo comportamento dos endereços e teste exemplos que devem continuar liberados.
Se uma combinação já está indexada e precisa sair, o Google tem de conseguir ler a instrução de exclusão antes de um eventual bloqueio de rastreamento. Se a seleção tem procura própria e merece uma página de categoria, o trabalho é outro: manter uma URL estável, com links e conteúdo que atendam àquela seleção. Tratar os dois casos da mesma forma costuma criar novas pendências.
Cache HTTP e redirecionamentos também entram na conta
Ao atualizar um link interno, aponte para o destino final. O caminho HTTP → HTTPS → URL antiga → URL atual exige mais pedidos do que um link direto à página atual. Preserve os redirecionamentos necessários para acessos antigos, mas não continue criando a cadeia dentro do próprio site.
Para conteúdo que não mudou, o servidor pode responder 304 Not Modified a uma requisição condicional válida. O Google reaproveita a cópia que já tem, economizando transferência. A equipe precisa manter os validadores de cache coerentes, como ETag ou Last-Modified: devolver 304 depois de uma mudança real faz o bot continuar com a versão anterior.
Existe uma configuração para aumentar o crawl budget?
O Search Console não oferece um campo para escolher quantas visitas o Google fará. O buscador ajusta esse ritmo pela capacidade do host e pela demanda de rastreamento. A diretiva crawl-delay também é ignorada pelos rastreadores do Google.
Se produtos estão esperando, trabalhe sobre a causa encontrada: recuperar respostas estáveis, publicar links até os itens e reduzir combinações sem função no catálogo. Meça a chegada às páginas afetadas, em vez de tentar alcançar um total de solicitações.
Como medir o efeito das mudanças
Volte ao mesmo grupo de páginas depois da mudança. Primeiro, confirme que o servidor entrega a versão corrigida. Depois, veja se o Google voltou a essas URLs e qual resposta recebeu. Só então compare a situação de indexação.

Essa sequência separa três momentos que podem ocorrer em datas diferentes: publicação do ajuste, nova visita e processamento na Pesquisa. Defina com a equipe quem verifica cada etapa. Uma configuração publicada no painel, mas ainda presa no cache, continua entregando a resposta antiga para quem acessa.
Também compare a composição dos acessos. Se o problema era a quantidade de combinações de filtros, procure a redução dessas URLs nos novos rastreamentos e a chegada às páginas que interessam. Um número total maior, sem essa mudança, não responde à dificuldade inicial.
Para aprofundar as regras de capacidade e demanda, a orientação sobre cota de rastreamento detalha os fatores que o Google considera. No trabalho de SEO técnico, o diagnóstico precisa ligar essas regras ao que o seu servidor e as suas páginas estão entregando.
Conclusão
Eu trataria o crawl budget como uma pergunta sobre o site: quais endereços o Google está encontrando, o que recebe ao visitá-los e por que algumas páginas importantes ainda esperam? Os registros e os exemplos do Search Console permitem responder com mais precisão do que uma meta de visitas do robô.
Você pode levar essa questão para uma auditoria de SEO técnico. Com as páginas afetadas e o histórico de acesso, podemos definir o que precisa mudar na navegação, nos modelos ou na entrega do servidor.