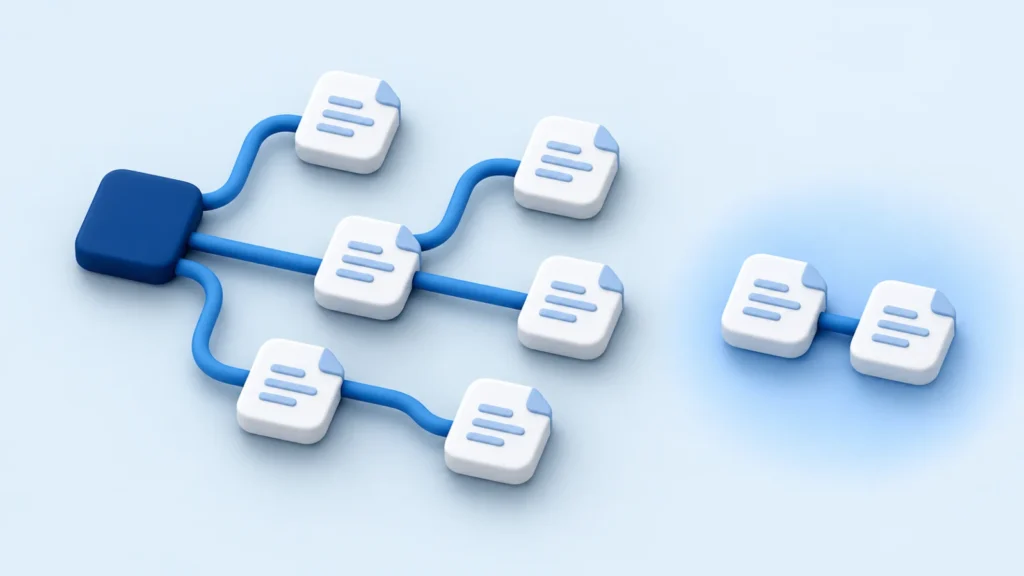
Uma página pode continuar publicada mesmo depois de sair do menu, de uma categoria ou dos artigos que apontavam para ela. O endereço abre, alguém ainda chega por um link antigo, mas quem entra pela página inicial não encontra mais o caminho. É esse tipo de situação que a busca por páginas órfãs precisa revelar.
A correção começa por descobrir o que ficou isolado e qual função aquilo ainda tem. Uma página de serviço atual merece voltar à navegação. Uma campanha encerrada pede outra decisão. Sair distribuindo links para tudo o que aparece no relatório pode devolver ao site conteúdos que já deveriam ter sido retirados.
Quando uma página fica órfã
Uma página fica órfã quando não há um caminho de links internos até ela a partir do ponto inicial do rastreamento, normalmente a home. Ela pode ter links de saída e até receber links de outras páginas que também ficaram isoladas.
Imagine apenas a relação entre dois endereços: A aponta para B, e B aponta para A. Se nenhuma página acessível da navegação leva a esse par, as duas continuam fora do percurso principal. Contar links recebidos sem verificar de onde eles vêm esconde essa situação.
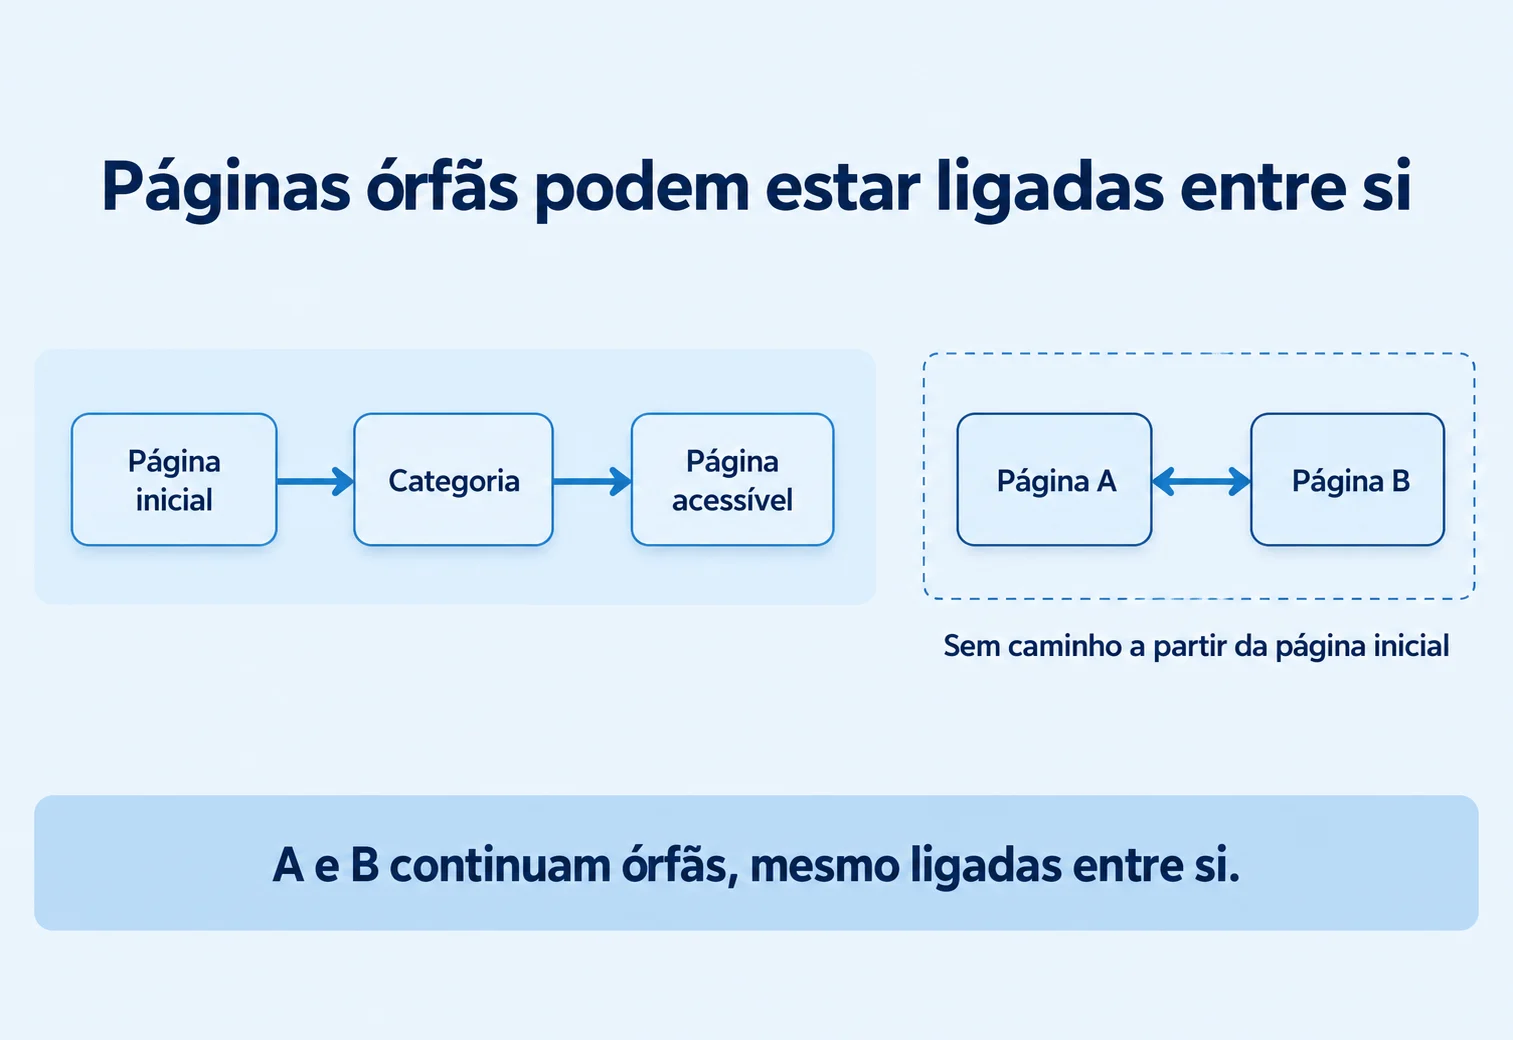
Também não confunda uma página órfã com uma página pouco linkada. Um serviço acessível por um único link pode ter uma distribuição fraca, mas existe um caminho até ele. Já uma página órfã pode continuar indexada porque o Google conheceu o endereço antes ou o encontrou em outra origem.
Essa diferença faz parte da revisão de SEO técnico: primeiro entender o percurso que o site oferece, depois decidir como reorganizá-lo.
De onde tirar a lista de páginas que deveriam existir
Um rastreador seguindo links encontra o que está conectado. Para descobrir o que ficou de fora, você precisa de pelo menos outra lista de endereços. Eu começaria pelo conteúdo publicado no painel e pelos sitemaps gerados pelo site.
Peça uma exportação das URLs públicas de produtos, serviços e artigos. Separe o que está publicado do que é rascunho, privado ou foi encerrado. Depois reúna os endereços do sitemap. As duas listas podem divergir por configuração ou por arquivos antigos, e essa diferença já merece leitura.
O Search Console, o Analytics e os logs acrescentam URLs que receberam impressões, visitas ou solicitações. Eles são úteis para encontrar páginas esquecidas que ainda participam do negócio. Mas esses históricos não equivalem a uma lista completa do que está publicado hoje.
Uma URL que teve cliques meses atrás pode agora redirecionar ou responder 404. Outra página, recém-publicada e ainda sem visitas, talvez nem apareça nesses relatórios. Guarde a origem de cada endereço para saber o que aquela lista realmente representa.
Como comparar essa lista com os links do site
Você vai comparar dois conjuntos: as páginas conhecidas por essas fontes e as páginas alcançadas pelos links. O que estiver no primeiro conjunto e não no segundo vira uma lista para revisar. Ainda falta abrir os endereços e entender por que ficaram de fora.
Rastreie a partir da página inicial
Faça uma coleta com um crawler, como Screaming Frog ou Sitebulb, começando pela home. Para esse teste, interessa saber quais páginas ele alcança seguindo a navegação. Se você apenas entregar uma lista de URLs para ele acessar, estará testando aquelas respostas, sem demonstrar o caminho até elas.
As integrações de sitemap, Analytics e Search Console podem trazer os endereços adicionais na mesma coleta, desde que o relatório diferencie como cada um foi descoberto. O Screaming Frog tem filtros próprios para páginas órfãs após a análise do rastreamento; esse fluxo com configuração e integrações exige licença.
Antes de interpretar a ausência de uma página, veja se a coleta terminou e quais limites estavam ativos. Bloqueios, exclusões de pastas, profundidade máxima e falta de execução de JavaScript podem interromper um caminho que existe para outros tipos de acesso.
Compare os endereços usando o mesmo padrão
As listas precisam usar URLs comparáveis. Um relatório pode guardar o endereço antigo em HTTP; outro, a versão atual em HTTPS. A mesma página também pode aparecer com parâmetros de campanha.
Resolva essas diferenças com cuidado. Não apague todos os parâmetros para facilitar a comparação: em algumas plataformas, eles identificam páginas ou seleções diferentes. Guarde a URL original e a versão usada no cruzamento, junto com a resposta e o destino final, quando houver redirecionamento.
Em uma planilha, dá para começar com uma coluna para o endereço e outra indicando se ele apareceu no rastreamento por links. As páginas ausentes devem permanecer separadas por origem e tipo de conteúdo. Isso evita misturar um serviço atual com um caminho antigo já redirecionado.
Abra as diferenças antes de chamar tudo de erro
Para cada URL ausente, veja o que o servidor entrega. A página existe? Está pública? É a versão atual ou uma cópia? Se há redirecionamento, qual é o destino? Essas respostas determinam a correção.
Depois tente reconstruir o percurso esperado. Um produto deveria aparecer numa categoria, um artigo no acervo e um serviço na apresentação da empresa. Se o link existe apenas depois de um clique que o crawler não executou, a revisão passa também pela forma de carregar essa navegação.
O guia de localização de páginas órfãs no Screaming Frog detalha o cruzamento das fontes e a análise posterior. Mesmo usando o relatório integrado, eu manteria essa conferência manual nos endereços que você pretende corrigir.
Um cruzamento de planilha que você consegue repetir
Na primeira aba, cole as URLs publicadas que vieram do painel ou do sitemap. Guarde a origem numa segunda coluna. Na aba Rastreamento, cole apenas os endereços encontrados seguindo links a partir da home. Antes de comparar, confirme se os dois arquivos usam o mesmo protocolo e padrão de domínio.
Se a URL está em A2 e as URLs alcançadas estão na coluna A de Rastreamento, uma fórmula de Excel em português é:
=SE(A2="";"";SE(SOMARPRODUTO(--EXATO(A2;Rastreamento!$A$2:$A$5000))=0;"Revisar";"Encontrada"))Os nomes das funções e os separadores podem mudar conforme o idioma da planilha. Ajuste o fim do intervalo, aqui na linha 5000, para incluir toda a sua lista. A fórmula deixa linhas vazias sem resultado e marca “Revisar” quando o endereço não aparece no intervalo comparado.
A função EXATO diferencia maiúsculas e minúsculas e compara os caracteres literalmente. Isso importa nas URLs: CONT.SE ignora a caixa e interpreta ? e * como curingas. Uma URL com parâmetros poderia coincidir com outro endereço sem representar a mesma página. Antes do cruzamento, padronize protocolo e domínio conforme a versão final, preservando os caminhos que o servidor trata como diferentes.
A coluna “Revisar” ainda pede abrir a URL: um limite da coleta ou um endereço antigo pode explicar a ausência.
Não transforme todos os caminhos em minúsculas por conveniência: alguns servidores tratam letras maiúsculas e minúsculas como URLs distintas. Também preserve a diferença entre /produto/ e /produto/?id=2 até saber o que a plataforma entrega. Resolva redirecionamentos e mantenha uma coluna com o endereço original, para não perder a pista de onde o problema começou.
Como usar o Screaming Frog para confirmar as candidatas
No modo Spider, informe a home e inicie a coleta. A aba Internal mostra o que o programa encontrou; ao selecionar uma URL, a aba inferior Inlinks mostra os links de entrada conhecidos. Exporte os endereços quando a coleta terminar. Essa primeira rodada deve preservar a descoberta pelos links, sem usar uma lista pronta como ponto de partida.
Para cruzar fontes dentro do programa, configure os sitemaps e as integrações de Analytics ou Search Console que fizerem sentido para o projeto. Depois execute Crawl Analysis > Start. Os filtros de páginas órfãs dependem dessa análise e das fontes configuradas. A versão gratuita limita a coleta a 500 URLs e não oferece o conjunto de integrações da licença paga; numa loja maior, uma coleta cortada nesse limite deixa parte do catálogo fora do teste.
Use o modo List em outra rodada para testar o status das URLs candidatas. Ele é útil para descobrir quais ainda respondem 200, quais redirecionam e quais foram removidas. Como você entregou os endereços ao programa, essa rodada não comprova que os visitantes conseguem chegar até eles pela navegação.
Ao comparar antes e depois, mantenha o mesmo ponto de partida e as mesmas opções de renderização. Se a segunda coleta passou a executar JavaScript e a primeira não, parte da diferença pode vir da configuração do teste, e não dos links publicados.
O que fazer com cada página encontrada
Comece pelas páginas que deveriam receber pessoas hoje. Para um serviço atual, escolha uma origem que explique por que o visitante deve seguir aquele link. Pode ser a lista de serviços ou uma orientação que apresente a necessidade daquele trabalho.
Nos produtos, olhe a categoria e a disponibilidade. Uma retirada temporária do catálogo pode ter removido o caminho sem encerrar a página. Se o item vai voltar, reveja como ele continua acessível e quais informações o comprador encontra durante a espera.
As decisões mais comuns são:
- Manter e reconectar: incluir links nas páginas que apresentam ou complementam aquele conteúdo.
- Consolidar: unir conteúdos equivalentes e redirecionar o endereço substituído para a página correspondente.
- Encerrar: retirar o conteúdo sem substituto e devolver uma resposta 404 ou 410, atualizando sitemap e referências.
- Preservar acesso restrito ou uma finalidade específica: respeitar a função da página, sem colocá-la na navegação pública por causa de um alerta.
Evite concentrar todos os links numa lista escondida ou inserir o mesmo rodapé em centenas de páginas só para mudar uma contagem. Os links internos devem ajudar alguém a continuar a navegação.
Também não redirecione todas as páginas esquecidas para a home. Quando não existe uma substituta equivalente, esse encaminhamento deixa o visitante sem o conteúdo que o link prometia.
Como escolher a página que vai receber o novo link
Abra a candidata e complete a frase: “Quem está lendo esta página procuraria isso quando…”. A resposta deve apontar um contexto real. Uma página de auditoria pode receber um link num diagnóstico de indexação; um produto precisa aparecer na categoria em que o comprador espera encontrá-lo. A âncora deve explicar esse destino com as palavras da própria frase.
Depois faça o caminho inverso. Abra a página de origem, encontre o trecho e avalie se o link continua fazendo sentido sem saber que ele foi incluído para SEO. Se o texto precisa interromper o assunto para apresentar o destino, provavelmente existe uma origem melhor. Um link visível no lugar certo vale mais para a navegação do que uma lista de URLs que ninguém entende por que está ali.
Grupos isolados exigem olhar além de uma página. Se dez artigos apontam uns para os outros, mas o arquivo do blog não leva a nenhum deles, reconecte a seção ao acervo. Acrescentar mais links entre esses dez endereços mantém o grupo fora do caminho que começa na home.
Uma primeira leitura com o analisador de links
Você pode usar o analisador de links internos para começar pela home e visualizar os caminhos de uma amostra. Informe a URL, escolha o limite e abra os resultados. Veja quantas páginas entraram, quantas ficaram na fila e qual foi a profundidade encontrada.
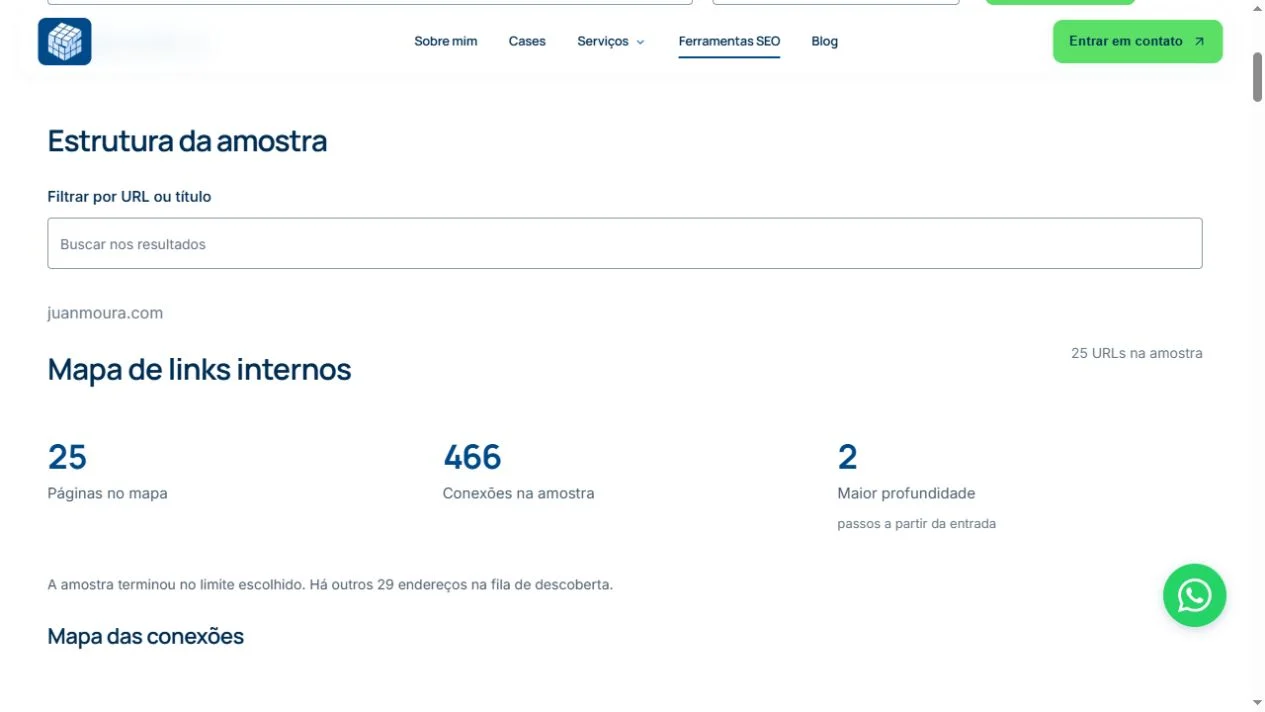
Na tela, a coleta atingiu o limite de 25 URLs. Outros 29 endereços estavam aguardando. Uma página ausente dessa amostra pode estar nessa fila. Para investigar uma candidata, amplie o levantamento apropriado e cruze com as fontes de URLs publicadas, como vimos na planilha.
Abra também os detalhes de uma página e veja as origens dos links. Muitos links do menu se repetem no site inteiro; isso não informa quantos links contextuais um artigo recebeu. Compare a origem, a âncora e o caminho de descoberta antes de escolher o que acrescentar.
Como evitar que o problema volte
Inclua o caminho de entrada na rotina de publicação. Antes de encerrar um serviço ou artigo novo, abra a seção em que ele deveria aparecer e siga o link até a página. Publicar e adicionar ao sitemap são partes diferentes dessa conferência.

Ao reformular menus ou categorias, compare a lista de páginas alcançadas antes e depois. É nessas mudanças que um grupo inteiro pode perder sua ligação com o acervo sem que nenhum endereço deixe de abrir.
Depois das correções, repita a coleta com os mesmos critérios e confirme que os caminhos pretendidos passaram a existir. No Search Console, você acompanha como o Google processa as páginas, mas não deve usar um pedido de indexação como substituto para reconectar a navegação.
Conclusão
Se o relatório trouxe muitas páginas órfãs, escolha primeiro as que continuam importantes para vendas ou atendimento. Abra cada uma e descubra de qual seção o visitante deveria chegar. A correção precisa devolver esse caminho, sem ressuscitar conteúdos que perderam a função.
Um acervo que cresceu sem organização pode exigir mais do que acrescentar alguns links. Na revisão de arquitetura do site, posso ajudar a definir o lugar de cada grupo de páginas e orientar as mudanças na navegação. Traga a estrutura atual e as páginas que você quer tornar mais fáceis de encontrar.